日前,衡水市气象局“智能预报预警技术应用创新团队”科研人员,正让机器学习“看”二十年的天气档案,用人工智能给预报员当起了“数据助手”。
每到夏季,我市常常遭遇短时强降水、雷暴大风、冰雹等强对流天气。这类天气发展迅猛,短时间内就可能砸坏庄稼、淹了街道、掀翻广告牌,威胁群众生命财产安全。
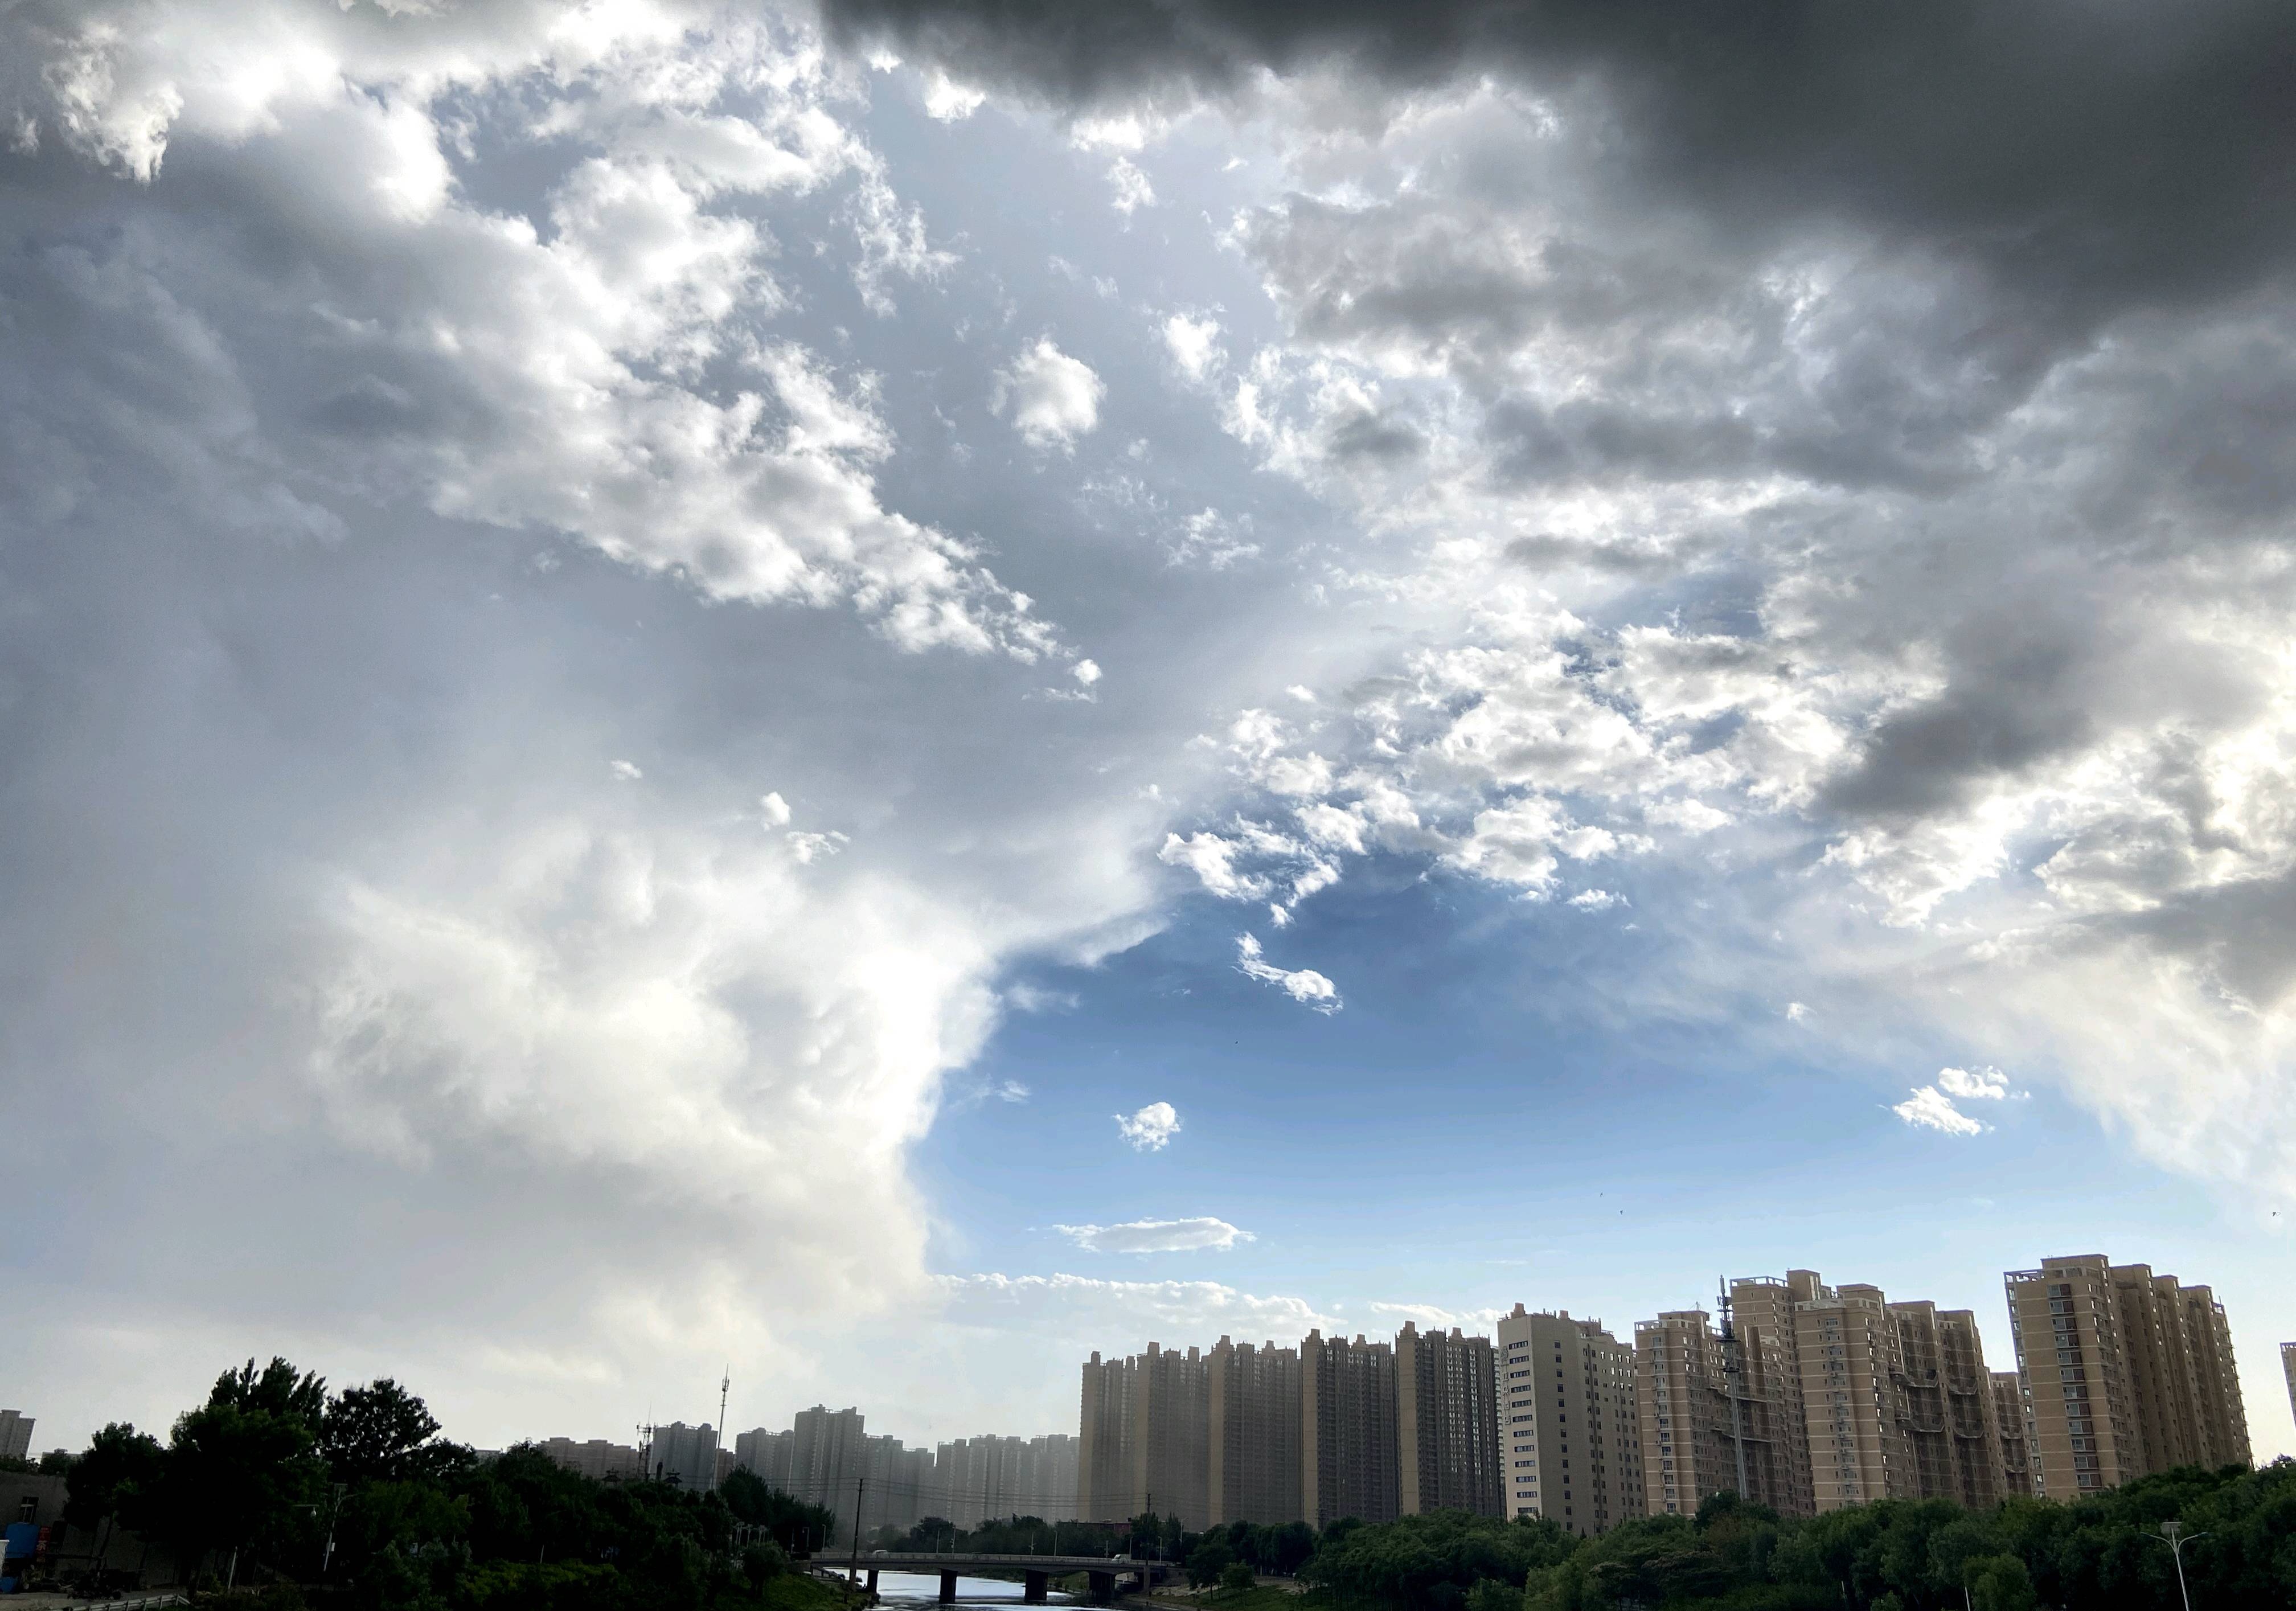
强对流天气一直是天气预报的“难点”,因为不同的强对流天气,需要的“配料”不一样。短时强降水需要充足水汽,冰雹需要特殊的冷暖空气堆叠,雷暴大风又依赖另一种风场结构。预报员要同时看懂上百个气象变量,再凭经验判断“今天到底会下哪种”,几乎不可能做到面面俱到。更麻烦的是,强对流从酝酿到爆发往往只有几十分钟,留给预报员反应的时间窗口极短。
为了啃下这块硬骨头,衡水市气象局“智能预报预警技术应用创新团队”科研人员引入了一种叫“随机森林”的机器学习算法。让计算机去“啃”历史天气档案。研究团队收集了邢台、张家口、乐亭三个探空站近20年的高空观测数据,再叠加数值天气预报产品和气象灾情记录,搭了两套预报模型。
第一套模型基于高空实况探测数据,把天气分成四类:短时强降水、雷暴大风、冰雹、无强对流。第二套模型结合数值预报产品,把现实中“两种甚至三种灾害同时出现”的复合天气也纳入考量,一共划分为 8 类结果。计算机做的事情,不只是温度和湿度,更是它们背后的组合关系,本质上是从海量历史样本中自动总结规律:什么样的大气环境组合,更容易催生哪一种强对流。
经过检验,两套模型的整体误判率分别为2%–5%和6%,对实况的预报准确率可以达到55%–59%。遇到大范围强对流过程时,预报表现更稳。更有意思的是,模型自己“找”出了关键线索:高低空环流怎么配合、空气上升运动强不强、低层水汽够不够多,这三件事是决定强对流会不会发生的核心。
不同灾害也各有“偏好”——水汽充沛时更容易触发短时强降水;而一种特殊的不稳定层结环境,更利于冰雹形成。这些规律和气象专家的经验判断基本吻合,说明机器学习没有“瞎猜”。
当然,这套智能模型也有短板。多种灾害叠加的复合强对流天气本身发生次数少,喂给计算机学习的样本不够多,识别精度自然上不去;各个探空站观测资料的时间长短不一致,也会影响局部地区的预报效果。
人工智能不会取代预报员。它的角色更像一个反应极快的“数据筛子”:把上百个变量在几秒内跑完,把可疑信号挑出来交给人。预报员依然负责最终判断和公众服务。未来,衡水市气象局“智能预报预警技术应用创新团队”还会持续积累天气样本、迭代算法,把模型逐步推向业务应用,为衡水群众的生产生活筑牢气象防灾减灾第一道防线。
 广告



 广告

 广告